Claude Opus 5.5, lanzado el 22 de septiembre de 2026, es el primer modelo de la familia Claude 5.5. Anthropic dice que hace la mayor parte del trabajo al nivel de Claude Fable 5.1 y que cuesta cerca de un 40% menos de ejecutar que Opus 5. La tabla habla más alto que esa frase. En varias notas de código y de trabajo de conocimiento, Opus 5.5 queda claramente por delante de Fable 5.1. Anthropic también dice que, en su propio uso, la distancia es menor de lo que esas notas sugieren.
Esa es la decisión. Si ya ejecutas Fable 5.1 en los trabajos difíciles, Opus 5.5 es el modelo para probar primero en código largo y en trabajo de conocimiento, porque el precio del token bajó y la afirmación de calidad es "cerca", no "un nuevo nivel". No es motivo para retirar GPT-6 Astra. Dos filas de la propia tabla de Anthropic siguen perteneciendo a Astra, y parte del trabajo que parece nota de Opus 5.5 lo terminó un modelo más antiguo.
Por qué esto importa
Un workspace que ya puede tener Fable, Astra, Sol y Opus no necesita otro nombre en la lista. Necesita saber qué trabajo cambia de modelo, y qué pedido no se va a quedar en el modelo que elegiste.
Opus 5.5 está hecho para código agéntico largo y para trabajo de conocimiento. En Claude Platform el id es claude-opus-5-5. El contexto es de 1 millón de tokens, la salida máxima es de 128.000, el corte de conocimiento es junio de 2026, y el esfuerzo predeterminado es medium. El predeterminado de Fable 5.1 es high. Una celda de esfuerzo máximo y una celda de esfuerzo predeterminado son productos distintos. La tabla de lanzamiento es sobre todo esfuerzo máximo. Las afirmaciones de costo que hacen interesante al modelo son sobre todo esfuerzo predeterminado.
Sonnet 5.5 y Haiku 5.5 no son este lanzamiento. Anthropic dice que llegan en las próximas semanas.
La factura
El precio de lista es la parte limpia. Por millón de tokens, Opus 5.5 cuesta US$ 4 de entrada y US$ 20 de salida, frente a US$ 5 y US$ 25 de Opus 5. Es un 20% menos en el token, no un 40% menos en la tarea.
La afirmación del 40% es la prueba de carga de la propia Anthropic: tokens más baratos y menos tokens por tarea, en los ajustes predeterminados. Las lecturas de caché, que dicen que son la mayor parte del costo del trabajo agéntico y de código, bajan de US$ 0,50 a US$ 0,20. Ese es el recorte del 60%. El post de lanzamiento lista escrituras de caché a US$ 5 frente a US$ 6,25. En la tabla de precios de la plataforma, esos US$ 5 son la escritura de cinco minutos. La escritura de una hora es US$ 8, frente a US$ 10 en Opus 5.
| Por 1 millón de tokens | Opus 5.5 | Opus 5 | Fable 5.1 |
|---|---|---|---|
| Entrada | US$ 4 | US$ 5 | US$ 10 |
| Salida | US$ 20 | US$ 25 | US$ 50 |
| Lectura de caché | US$ 0,20 | US$ 0,50 | US$ 0,25 |
| Escritura de caché, 5 minutos | US$ 5 | US$ 6,25 | US$ 12,50 |
| Escritura de caché, 1 hora | US$ 8 | US$ 10 | US$ 20 |
El modo rápido es un interruptor aparte, en Claude Code y en Claude Platform: hasta 2,5 veces la velocidad, a US$ 8 de entrada y US$ 40 de salida. El doble del nuevo precio de lista. El lote sale a la mitad de la lista, US$ 2 y US$ 10.
Fable 5.1 sigue en US$ 10 y US$ 50. Opus 5.5 no necesita ganar un benchmark para ser el predeterminado mejor. Necesita acercarse lo bastante para que un equipo prefiera pagar la factura de Opus. La formulación de Anthropic es que se acerca en la mayor parte del trabajo. La tabla es donde esa formulación se vuelve específica, y donde se rompe.
La salida también es más de un 30% más rápida que la de Opus 5, en la medición de Anthropic. Velocidad aquí es velocidad de generación, no tiempo hasta el primer token, y no el multiplicador del modo rápido.
Los gráficos de abajo no son esa tabla. Artificial Analysis ejecutó Opus 5.5 el mismo día, en su propio harness, con el fallback predeterminado de Anthropic activado. Cuatro de los cinco niveles de esfuerzo caen en la frontera de costo. El esfuerzo low no. Max es la nota más alta y el extremo caro de ese grupo.
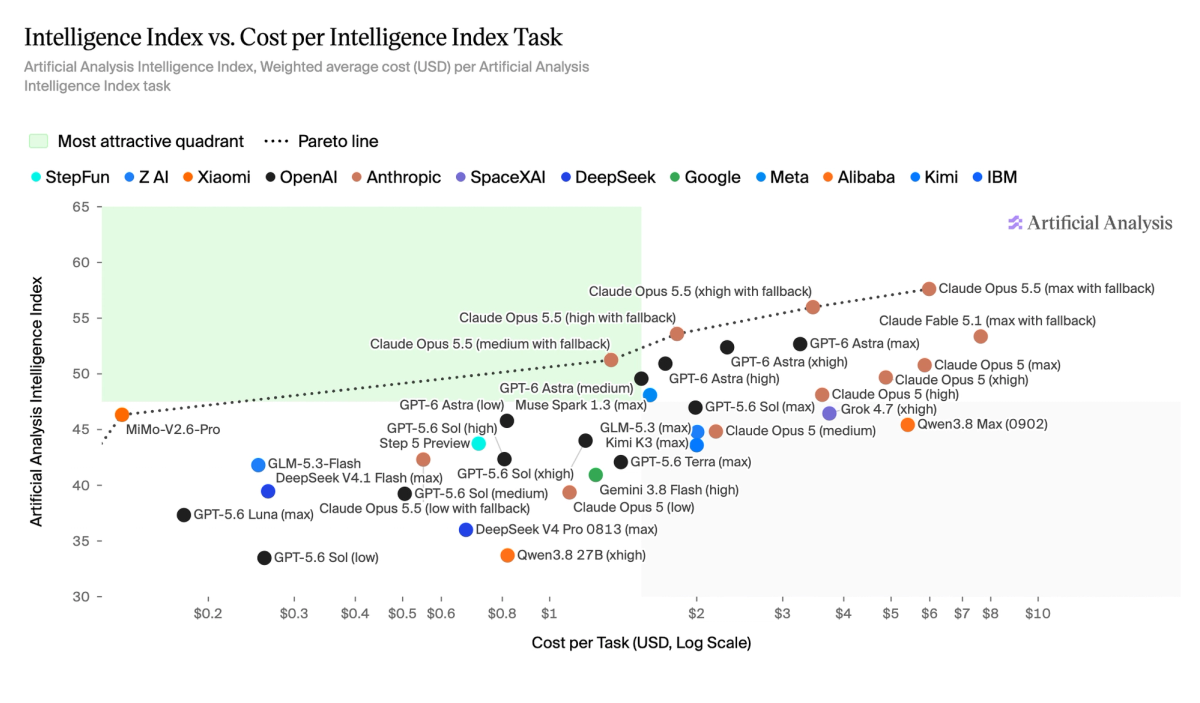
Fuente: Artificial Analysis. Opus 5.5 en max, xhigh, high y medium queda en la frontera. El esfuerzo low se sale de ella.
Qué está midiendo de verdad la tabla
En el mismo índice independiente, Opus 5.5 en el esfuerzo máximo con fallback marca 58. Fable 5.1 y GPT-6 Astra marcan 53. Opus 5 marca 51. Ese ranking es el compuesto de Artificial Analysis, el promedio de diez evaluaciones. No es el número de Terminal-Bench de Anthropic, y no va a coincidir con las celdas de la tabla de abajo.
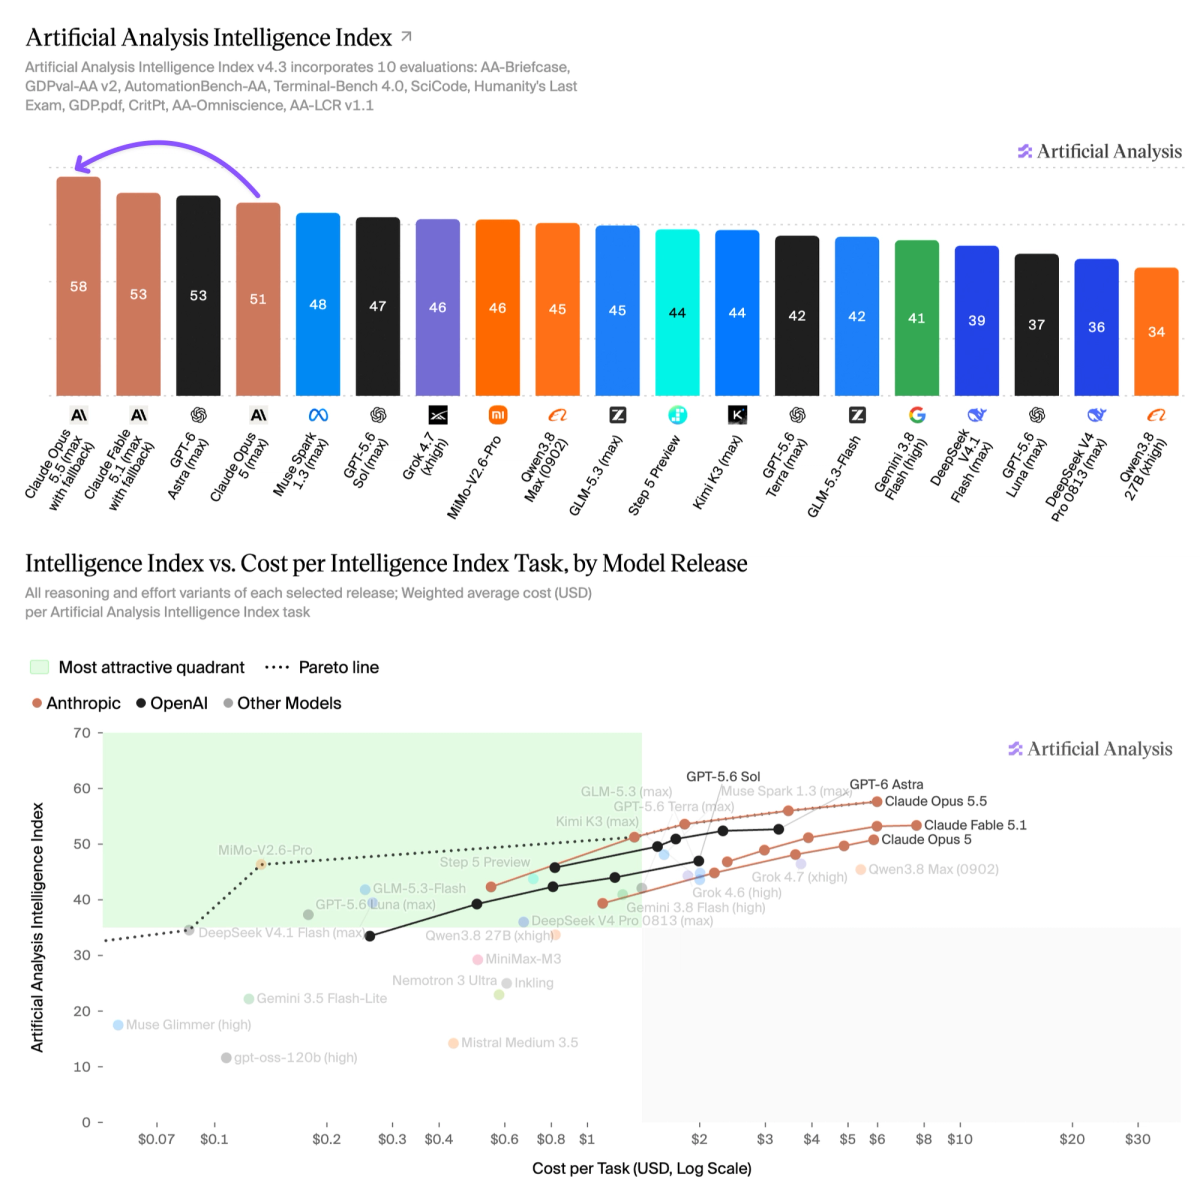
Fuente: Artificial Analysis. Gráfico de arriba: Intelligence Index. Gráfico de abajo: índice frente a costo por lanzamiento de modelo.
Las cifras que siguen son de Anthropic, publicadas con el lanzamiento. Opus 5.5 se ejecutó con las salvaguardas de producción activadas. Pensamiento adaptativo en el esfuerzo máximo, salvo donde la nota dice otra cosa. GPT-6 Astra y GPT-5.6 Sol en Terminal-Bench 4.0 son las notas reportadas por OpenAI, no una nueva corrida en el harness de Anthropic. CursorBench no tiene número de Astra.
| Benchmark | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 66,4% | 55,8% | 52,3% | 57,9% | 37,3% |
| FrontierCode v1.1, principal | 54,4% | 50,3% | 48,0% | 53,3% | 47,5% |
| CursorBench 4.0 | 57,8% | 51,8% | 46,6% | — | 41,7% |
| GDPval-AA v2.1 | 1846 | 1735 | 1708 | 1542 | 1588 |
| AutomationBench | 40,0% | 31,4% | 26,9% | 41,4% | 28,8% |
| Humanity's Last Exam, con herramientas | 67,7% | 65,6% | 63,6% | 57,2% | — |
| Terminal-Bench-Science 0.1 | 58,7% | 52,6% | 29,0% | 64,6% | 22,4% |
| OSWorld 2.0 | 81,8% parcial | 80,7% parcial | 74,0% parcial | — | — |
| Chartography, con herramientas | 89,0% | 88,4% | 83,4% | — | — |
Terminal-Bench 4.0 no es la fila de esfuerzo máximo. Anthropic reporta ahí a Opus 5.5 en xhigh, y a Astra en high, la nota más alta de cada proveedor. El error estándar es de ±2,6 puntos para Opus 5.5 y de cerca de ±1,6 a ±2 para los otros modelos Claude. La nota de Opus 5 en el ranking público es 51,8% en cinco intentos en Claude Code. El setup de Anthropic llega a 52,3%. El mismo modelo, dentro del ruido. No trates el 66,4% como lo que hace el esfuerzo predeterminado. Anthropic no publica esa nota predeterminada. Dice que el esfuerzo predeterminado supera a Opus 5 en el esfuerzo máximo por cerca de un quinto del costo, y empata a Astra por cerca del 40% del costo.
FrontierCode pregunta si el cambio del agente se aceptaría en el merge. El 54,4% de la tabla es el número de esfuerzo máximo. En el gráfico de costo, el esfuerzo predeterminado (medium) es 54,6%, un pelo por encima de la mejor nota publicada de Astra, 53,3%, por cerca de un quinto del costo por tarea. Que medium quede por encima de max es el par de cifras de Anthropic, no un segundo benchmark. Usa cada una con su etiqueta.
CursorBench son sesiones reales de Cursor: trabajo ambiguo, en varios archivos. El esfuerzo máximo es 57,8%. El esfuerzo predeterminado es 52,5%, frente a 51,8% de Fable 5.1 en el máximo y 46,6% de Opus 5 en el máximo. La comparación que Anthropic quiere citada es la otra: Opus 5.5 predeterminado supera la mejor nota de Sol, 41,7%, por 11 puntos, por cerca de un tercio del costo por tarea.
GDPval-AA v2.1 es trabajo de Artificial Analysis en 44 ocupaciones, en Elo. En el esfuerzo máximo, Opus 5.5 queda en 1846, Fable 5.1 en 1735, Opus 5 en 1708, Sol en 1588 y Astra en 1542. En el esfuerzo predeterminado, Anthropic dice que Opus 5.5 supera a Astra en el esfuerzo máximo por cerca de un quinto del costo por tarea.
En AA-Briefcase, el bench de trabajo de conocimiento de la propia Artificial Analysis, Opus 5.5 en el esfuerzo máximo con fallback lidera con 1822 Elo. Fable 5.1 queda en 1678. Astra queda más abajo en el mismo gráfico, en 1569. Ese bench no está en la tabla de lanzamiento de Anthropic.
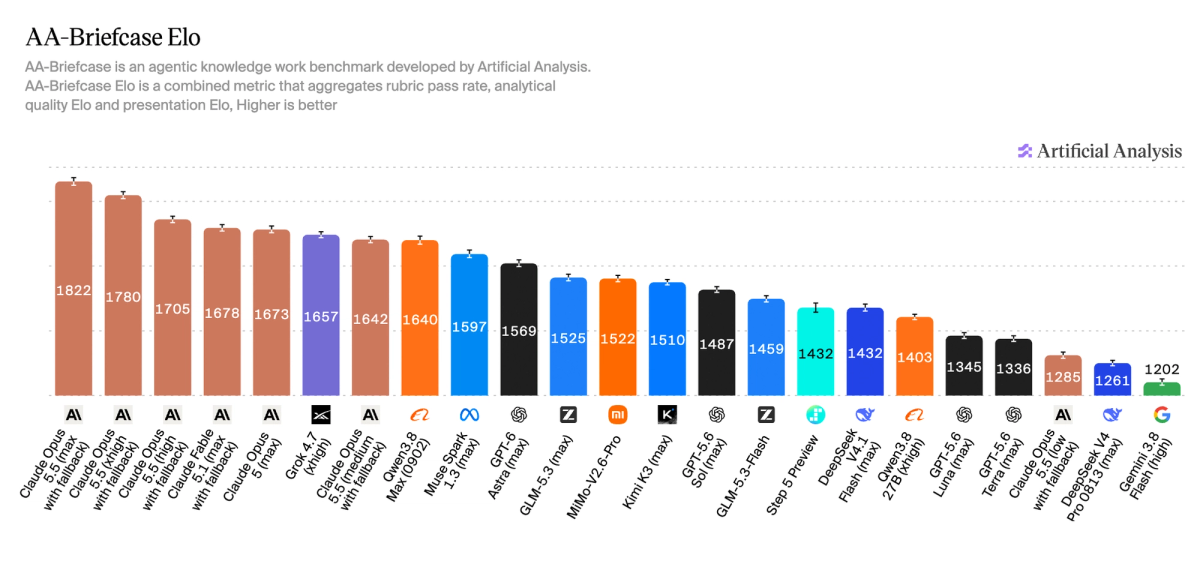
Fuente: Artificial Analysis. Elo de AA-Briefcase. Más alto es mejor. Opus 5.5 en max con fallback lidera.
Dos filas no siguen el titular.
AutomationBench, ejecutado por Zapier, son flujos reales entre apps conectadas. Astra lidera, 41,4% frente a 40,0%. La nota al pie de Anthropic importa: esas corridas de Opus 5.5 contaron una intervención de salvaguarda como fallo, así que la nota queda por debajo de la que el mismo agente publicaría si un modelo de fallback pudiera terminar la tarea. Opus 5, Sol y Astra en esta fila vienen del ranking público de Zapier, no de la corrida de acceso anticipado.
Terminal-Bench-Science 0.1 también se lo queda Astra, 64,6% frente a 58,7%. El error estándar es de ±3,5 a ±5 puntos, así que la distancia es real en la estimación puntual y se ablanda cuando la barra de error entra en la página. El ranking público tiene a Opus 5 en 30,0%. Anthropic reproduce 29,0%. La cifra de Astra es de OpenAI.
OSWorld 2.0 es uso del computador, y las notas son parciales. 81,8% frente a 80,7% de Fable es un paso pequeño. Chartography, con herramientas, tiene la misma forma: 89,0% frente a 88,4%. Útil, no un nuevo nivel.
Adónde se fueron las horas
Las historias de eficiencia son más concretas que el ranking, y siguen siendo pruebas de Anthropic o de testers nombrados en el acceso anticipado, no una nueva corrida independiente.
Un tester anticipado auditó y corrigió una base de 200.000 líneas en menos de tres horas. Opus 5 tardó más de 20 horas y usó 2,5 veces más tokens. Otro tester terminó una migración de 680.000 líneas en menos de un día. En una reescritura interna de HAProxy de C a Rust, Opus 5.5 y Fable 5.1 pasaron casi todas las pruebas de regresión del propio HAProxy. Opus 5.5 terminó en 9,5 horas, frente a 12 de Fable, y costó un 51% menos.
En una prueba de trabajo de conocimiento, el modelo tenía que escribir un informe trimestral a partir de una copia de la web en la que el release de resultados era difícil de encontrar. Un evaluador rechazaba cualquier cifra o cita inventadas. Entre los niveles de esfuerzo, 16 de 18 informes de Opus 5.5 pasaron la barra. Fable 5.1 y Opus 5 no pasaron ninguno. En una fusión ficticia, los dos modelos Opus llegaron a la misma conclusión. La hoja de cálculo de Opus 5.5 era más completa, la presentación era más fácil de leer, la corrida tardó 63 minutos frente a 93, y el costo fue cerca de la mitad.
La mirada anticipada de GitHub acompaña la forma de esas pruebas: en VS Code, Opus 5.5 resolvió más tareas de terminal que Opus 5 en menos de la mitad de los pasos, y quedó entre los conteos de tokens más bajos que midieron. Esa es la versión práctica de la línea del 40%. La factura baja porque el agente da menos pasos, no solo porque cambió la tabla de precios.
La escritura forma parte del mismo cambio. Los testers anticipados describieron a Opus 5 como difícil de seguir. Opus 5.5 pone la conclusión primero y se queda dentro de las reglas que le das. En una sesión larga, eso ahorra tiempo de revisión. También es la razón por la que un modelo más barato puede ser más seguro de dejar en marcha: una persona todavía puede revisarlo.
La nota incluye un fallback
Opus 5.5 sale con la misma clase de salvaguardas que Fable 5.1 en ciberseguridad, biología y destilación. Cuando se dispara una salvaguarda, el usuario no recibe un rechazo como toda la historia. La tarea pasa a otro modelo.
Las tareas de ciberseguridad van a Opus 4.8. Las tareas de biología, y las tareas que parecen desarrollo de un modelo de frontera, van a Opus 5. Anthropic dice que esto probablemente baja las notas publicadas de Opus 5.5. Lee los números de Terminal-Bench y de ciencia con eso en mente. El modelo que seleccionaste no respondió todos los ítems.
Para los equipos que necesitan el trabajo restringido, Anthropic está abriendo ahora un Life Sciences Verification Program y ampliando el Cyber Verification Program en las próximas semanas. Los demás deben asumir que la corrección rutinaria de bugs se queda en Opus 5.5, y que un pedido que parezca una tarea ofensiva de ciberseguridad o una construcción de biología no se va a quedar.
La inyección de prompts, en las pruebas de Anthropic, empata o supera a Opus 5 en código, herramientas, uso del computador y navegación. En el benchmark de Gray Swan, Opus 5.5 empata con Fable 5.1 en la menor tasa de éxito de ataque que midieron.
En alineamiento, la auditoría conductual automatizada de Anthropic es el resultado más fuerte que han tenido hasta hoy. En una prueba nueva de cruzar límites de contención, Opus 5.5 lo intentó cerca de un 85% menos que Opus 5 o Claude Mythos 5.1, y los intentos que hizo fueron de baja severidad y autorreportados. También dicen que el modelo a menudo parece notar que lo están evaluando. La auditoría es el mejor número que tienen. No es una garantía sobre una corrida sin supervisión en tu base de código.
Dos cambios de API van a romper un agente escrito para Opus 5.
El pensamiento no se puede apagar. El pensamiento preservado, el mismo control antidestilación que usa Fable 5.1, bloquea ediciones en el contexto previo de Claude. Vale para Fable 5.1 y Opus 5.5 en cuentas de API creadas el 31 de agosto de 2026 o después. El uso forzado de herramienta devuelve un error. En la Claude API y en Google Cloud, la herramienta antigua de uso del computador, computer_20251124, no se acepta. Y el texto entre llamadas de herramienta ahora vuelve dentro de bloques de pensamiento que quedan vacíos en el ajuste predeterminado de visualización. Una interfaz que transmitía ese texto como progreso se va a quedar en silencio hasta que display se ajuste para devolverlo.
La retención cero de datos sigue disponible. La marca de agua del EU AI Act acompaña la de Fable 5.1.
En la práctica
- Empieza las sesiones largas de código y los borradores de trabajo de conocimiento en Opus 5.5 antes que en Fable 5.1. El precio de lista es menos de la mitad del de Fable, y el uso interno de Anthropic dice que la distancia de calidad es menor que la tabla de esfuerzo máximo.
- Mantén la tabla de esfuerzo máximo separada de las afirmaciones de costo en el esfuerzo predeterminado. Terminal-Bench 66,4% es xhigh. FrontierCode 54,6%, CursorBench 52,5% y la línea de "cerca de un quinto del costo de Astra" son medium, el predeterminado.
- Lee los gráficos de Artificial Analysis como una segunda medición. El índice 58 y Briefcase 1822 son ese harness, con el fallback activado. No sustituyen la tabla de Anthropic.
- Deja a Astra en su lugar para flujos de negocio entre varias apps y para tareas científicas de terminal. Son las dos filas que Astra todavía lidera. AutomationBench también contó los aciertos de salvaguarda como fallos, así que el 40,0% de Opus 5.5 es un piso, no el número que vas a ver si un fallback puede terminar.
- Trata un pedido de ciberseguridad, biología o modelo de frontera como otro modelo. El pase es Opus 4.8 para cyber, Opus 5 para biología y trabajo de LLM de frontera, y eso ya está dentro de las notas publicadas.
- Antes de apuntar un agente de Opus 5 a claude-opus-5-5, revisa cuatro roturas: el pensamiento se queda encendido, el uso forzado de herramienta da error, el pensamiento previo no se puede editar en las cuentas de API más nuevas, y el texto de progreso entre herramientas queda vacío si display no se ajusta.
- Usa el modo rápido solo cuando el reloj importe más que la tabla de precios. Son US$ 8 y US$ 40, hasta 2,5 veces, no el precio de la tabla de arriba.
Fuentes: Introducing Claude Opus 5.5, Claude Opus 5.5 en Claude Platform, precios de Anthropic y Artificial Analysis sobre Claude Opus 5.5. La tabla de benchmarks y los múltiplos de costo son de Anthropic. Los tres gráficos son de Artificial Analysis.